


ライセンス通知
このコードベースおよび関連するモデルの重みは FISH AUDIO COMMUNITY LICENSE の下でリリースされています。S2-Pro のモデルウェイトは引き続き Fish Audio Research License が適用されます。詳細は LICENSE を参照してください。
法的免責事項
私たちは、コードベースのいかなる違法な使用に対しても責任を負いません。DMCA およびその他の関連法に関する現地の規制を参照してください。
クイックスタート
ドキュメント
[!IMPORTANT] 効率を重視する方には SGLang-Omni の利用を強く推奨します。SGLang-Omni README を参照してください。
LLM エージェント向け
まず https://speech.fish.audio/ja/install/ を読み、ドキュメントに従って Fish Audio Drama 3(または S2-Pro)をインストール・設定してください。
モデル
| モデル | サイズ | 重み | 説明 |
|---|---|---|---|
| Drama 3 | 35B-A3B(トークンあたり 3B が活性化) | HuggingFace | 新世代のフラッグシップ。複数キャラクターのシーンと長尺コンテンツ向けで、マルチターン修正と部分編集に対応 |
| S2-Pro | 4B パラメータ | HuggingFace | 前世代のフラッグシップ。より高速な推論 |
モデル種別は重みディレクトリの config.json から自動判定され、両者は同じコマンドラインと API サーバーを共有します。
Fish Audio Drama 3
S2-Pro を全面的にアップグレードした新世代の音声生成モデル。
Drama 3 は S2 シリーズと同様にマルチ話者・音声クローン・自然言語制御に対応しつつ、長尺音声の扱い、対話の仕方、編集性で明確な進化を遂げています。
主な特徴
- マルチターンディレクター修正:直前のテイクに対して直接指示を出し(「もう少し穏やかに、もう少し悲しく」)、モデルがコンテキストを踏まえて再生成します。最初からやり直す必要はありません。
- インフィル(音声の穴埋め)と精密編集:テキストを編集するように音声を編集し、「水曜日」を「木曜日」に差し替えるような部分置換ができます。前後の音色とつなぎ目は自然に保たれます。
- シーン形式のマルチキャラクター生成:脚本の記述から、複数のキャラクターを含むシーンを一度に収録できます。長文のストリーミング合成にも対応します。
- 長い対話と長尺音声:長時間の録音や長期セッション向けに設計されており、長尺でもキャラクターと音色が安定します。
- 表現力の強化:笑い声、泣き声、ささやき、劇的な感情がリファレンスに引きずられなくなり、人間に近い表現の張りを得られます。
- 多言語音声クローン:言語をまたぐ音色クローンのエラー率(CER / WER)で新たな水準の SOTA を達成しました。
- 自然言語タグ制御:
[whisper]、[angry]、[laughing]などのインラインタグで感情と韻律を制御します。
S2-Pro からの変化
| 機能 | S2-Pro | Drama 3 |
|---|---|---|
| マルチ話者 | 対応 | 対応、シーン形式のマルチキャラクター生成 |
| 音声クローン | 対応 | 対応、多言語エラー率がより低い |
| インライン自然言語指示 | 対応 | 対応 |
| 部分編集 / インフィル | 非対応 | 対応 |
| マルチターンディレクター修正 | 非対応 | 対応 |
| 長尺コンテンツ | チャンク分割で生成 | 長い対話と長尺音声、ストリーミング対応 |
| 強い感情表現(笑い・泣き・ささやき) | 普通 | より強い |
効果
公開ベンチマークで S2 から大きく飛躍しています:多言語音声クローン(MiniMax Multilingual Testset)、自由形式の音声編集(Ming-Freeform)、マルチターン感情修正(Step-Audio-Eval)の 3 領域において、制御精度、多言語エラー率(CER / WER)、スタイル正確性のすべてで前世代を上回ります。
アーキテクチャ、学習レシピ、詳細な評価結果は技術レポートをご覧ください。
Fish Audio S2-Pro
自然言語による制御と感情表現に優れた前世代のフラッグシップモデルです。約 100 言語に対応し、コンシューマ向け GPU にも収まるサイズです。
- インライン自然言語指示:
[pause]、[excited]、[whisper]などのタグで、テキストの任意の位置の韻律と感情を制御します。 - ネイティブなマルチ話者生成:1 つのテキスト内で話者 ID によりキャラクターを区別でき、話者ごとに生成して連結する必要はありません。
- 高速な音声クローン:10〜30 秒のリファレンス音声で音色を再現できます。
- 一括生成:長尺音声を一度にストリーミング生成できます。
- 本番運用のストリーミング:H200 1 枚で RTF 0.195、初回音声まで約 100 ms。
オンラインデモは Fish Audio ウェブサイトで体験できます。詳細はブログ記事と技術レポートを参照してください。
S2-Pro のベンチマーク結果(クリックで展開)
| ベンチマーク | Fish Audio S2 | |------|------| | Seed-TTS Eval — WER(中国語) | **0.54%**(全体で最高) | | Seed-TTS Eval — WER(英語) | **0.99%**(全体で最高) | | Audio Turing Test(指示あり) | **0.515** 事後平均 | | EmergentTTS-Eval — 勝率 | **81.88%**(全体で最高) | | Fish Instruction Benchmark — TAR | **93.3%** | | Fish Instruction Benchmark — 品質 | **4.51 / 5.0** | | 多言語(MiniMax Testset)— 最高 WER | **24** 言語中 **11** 言語 | | 多言語(MiniMax Testset)— 最高 SIM | **24** 言語中 **17** 言語 | Seed-TTS Eval では、S2 は評価対象(クローズドソースを含む)の中で最低の WER を達成しています:Qwen3-TTS(0.77/1.24)、MiniMax Speech-02(0.99/1.90)、Seed-TTS(1.12/2.25)。Audio Turing Test では 0.515 が Seed-TTS(0.417)を 24%、MiniMax-Speech(0.387)を 33% 上回ります。EmergentTTS-Eval では、副言語学的特徴(勝率 91.61%)、疑問文(84.41%)、統語的複雑さ(83.39%)で特に強い結果を示しています。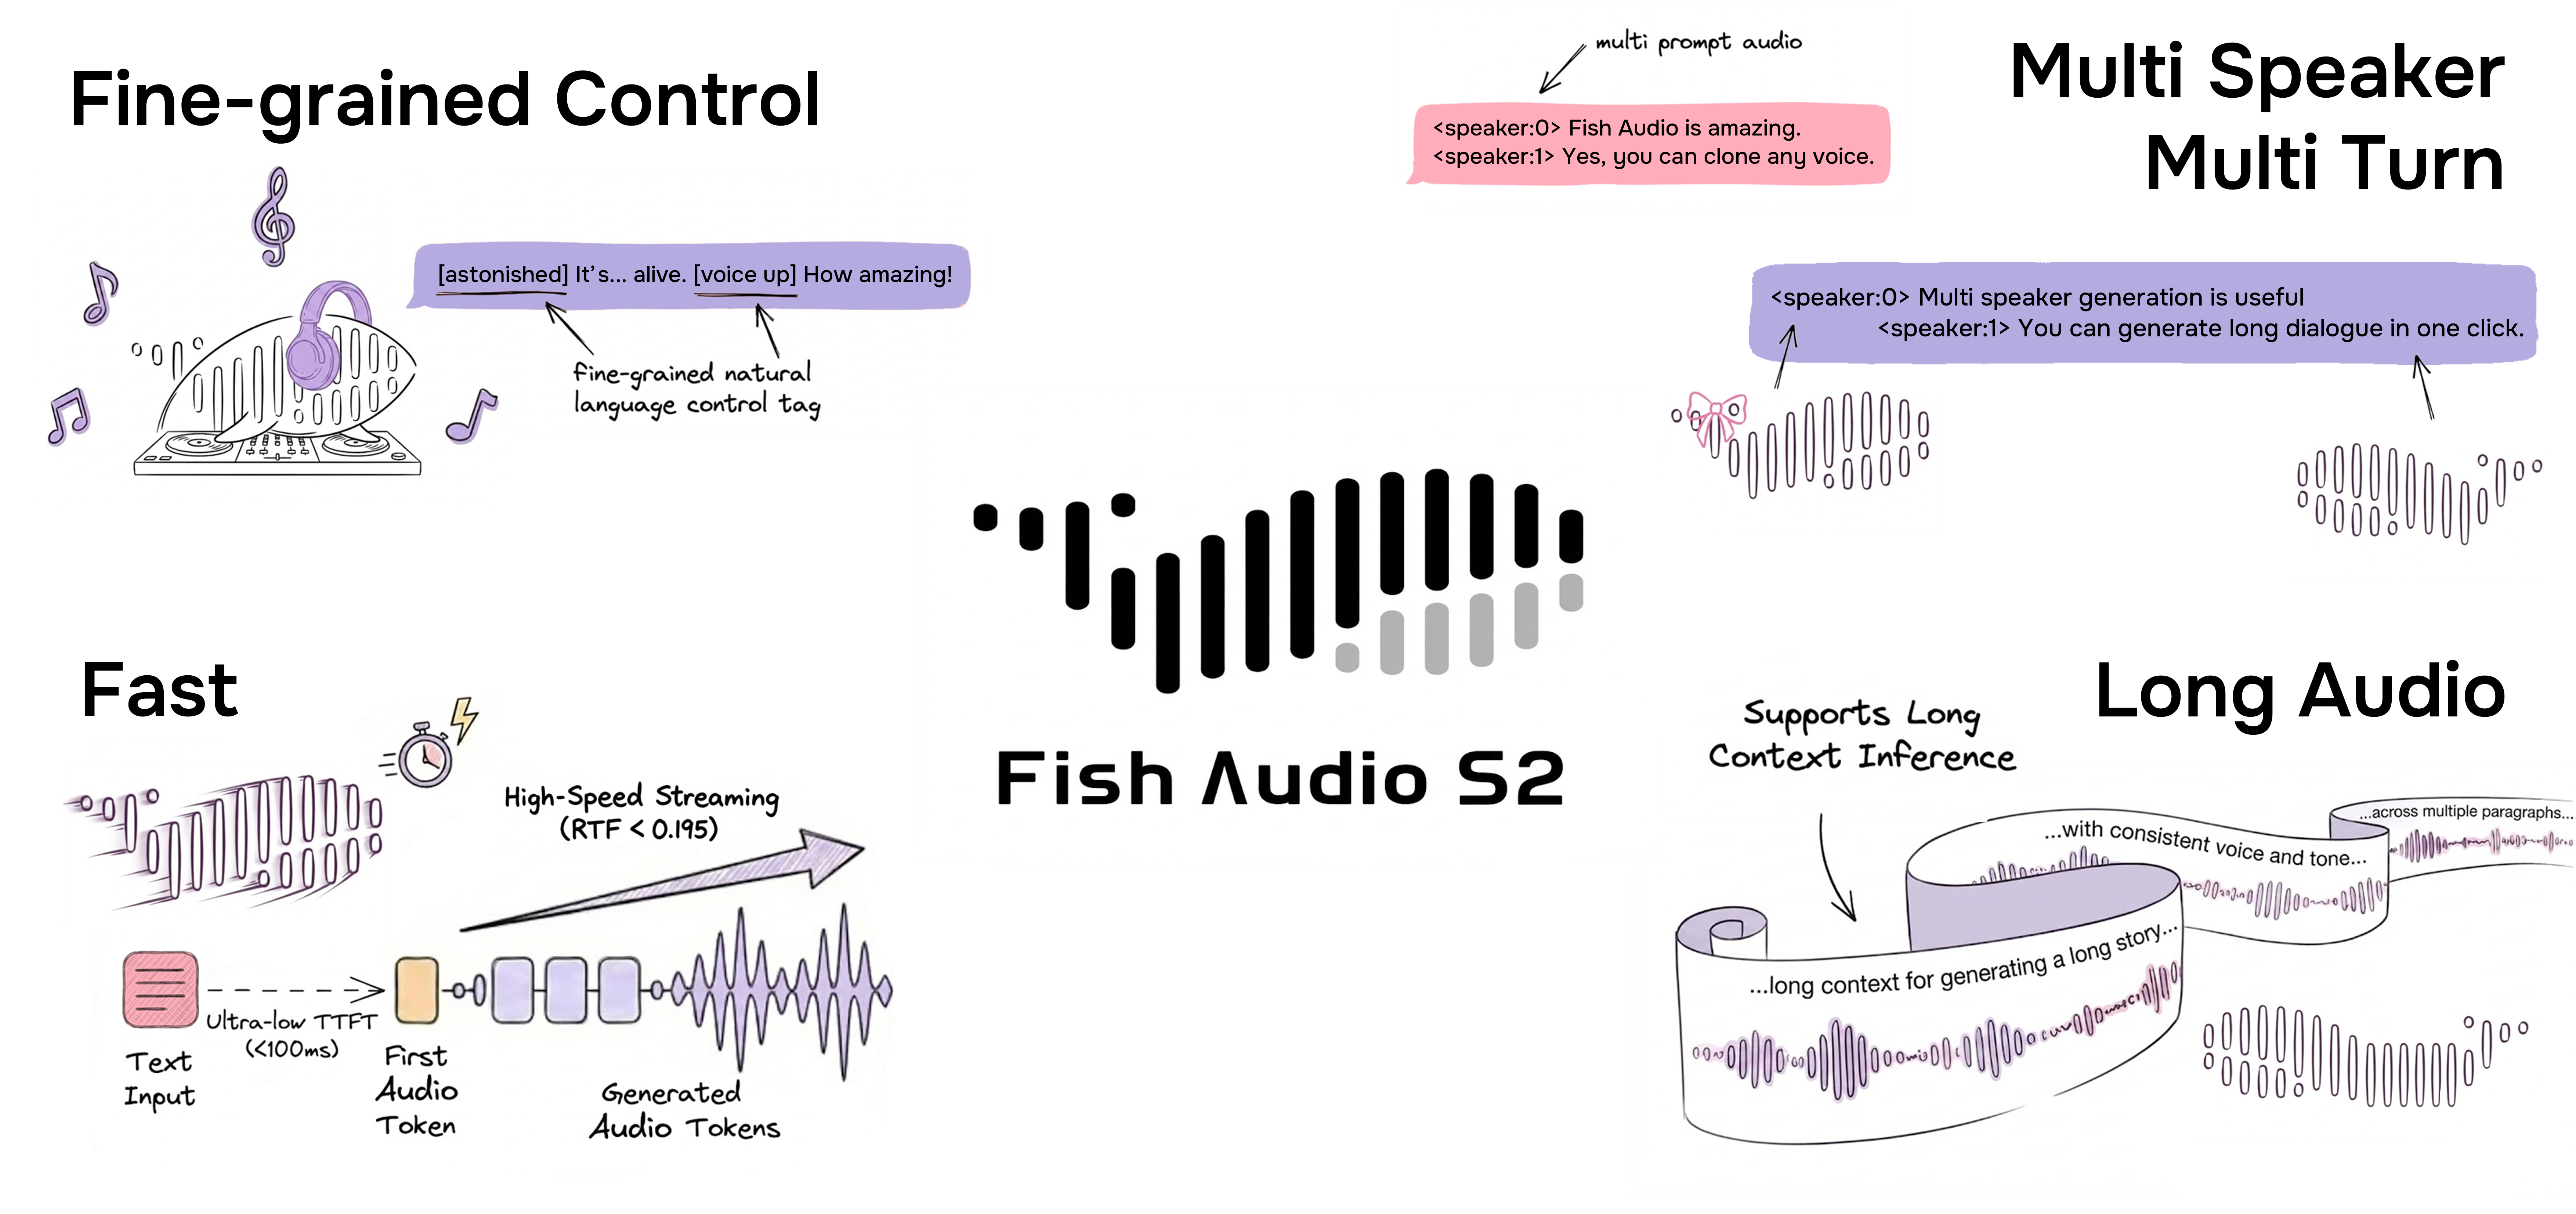
クレジット
技術レポート
@misc{fish-speech-v1.4,
      title={Fish-Speech: Leveraging Large Language Models for Advanced Multilingual Text-to-Speech Synthesis},
      author={Shijia Liao and Yuxuan Wang and Tianyu Li and Yifan Cheng and Ruoyi Zhang and Rongzhi Zhou and Yijin Xing},
      year={2024},
      eprint={2411.01156},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2411.01156},
}

@misc{liao2026fishaudios2technical,
      title={Fish Audio S2 Technical Report},
      author={Shijia Liao and Yuxuan Wang and Songting Liu and Yifan Cheng and Ruoyi Zhang and Tianyu Li and Shidong Li and Yisheng Zheng and Xingwei Liu and Qingzheng Wang and Zhizhuo Zhou and Jiahua Liu and Xin Chen and Dawei Han},
      year={2026},
      eprint={2603.08823},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2603.08823},
}

@misc{liao2026fishaudiodrama3technical,
      title={Fish Audio Drama 3 Technical Report},
      author={Dawei Han and Shidong Li and Shijia Liao and Jiahua Liu and Songting Liu and Qingzheng Wang and Yuxuan Wang and Xin Chen and Yifan Cheng and Tianyu Li and Gangin Park and Xuehao Yang and Chang Zeng and Haoyang Zhang and Ruoyi Zhang and Xiangyu Zhang},
      year={2026},
      eprint={2610.18010},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2610.18010},
}