


许可声明
此代码库及其相关的模型权重均在 FISH AUDIO COMMUNITY LICENSE 下发布。S2-Pro 权重仍适用 Fish Audio Research License。更多详情请参考 LICENSE。
法律免责声明
我们不对代码库的任何非法使用承担责任。请参考您当地关于 DMCA 和其他相关法律的法规。
快速开始
文档入口
[!IMPORTANT] 我们强烈建议追求效率的用户使用 SGLang-Omni 进行推理,请参考 SGLang-Omni README。
LLM Agent 指南
模型
| 模型 | 大小 | 权重 | 说明 |
|---|---|---|---|
| Drama 3 | 35B-A3B(每 token 激活 3B) | HuggingFace | 新一代旗舰模型,面向多角色场景与长内容,可多轮修正与局部编辑 |
| S2-Pro | 4B 参数 | HuggingFace | 前一代旗舰模型,有更快的推理速度 |
模型类型由权重目录中的 config.json 自动识别,两者共用同一套命令行与 API Server。
Fish Audio Drama 3
S2-Pro 基础上全方位升级的新一代语音生成模型。
Drama 3 与 S2 系列一样支持多说话人、声音克隆和自然语言控制,但在长音频处理、交互方式和可编辑性上有明显突破。
主要特性
- 多轮导演修正:对前一轮的生成结果直接进行指导("再温和一点、更伤感一些"),模型结合上下文重新生成,不用从头再来。
- 语音填空与精准编辑:像改文本一样改语音,进行「把周三换成周四」这类局部替换,同时前后音色与过渡保持自然。
- 剧本式多角色场景:按剧本描述一次性配出含多个角色的完整场景,并支持流式长文本合成。
- 长对话与长语音:面向长录音、长效会话设计,长内容中角色与音色保持稳定。
- 表现力更强:笑声、哭腔、耳语、戏剧化情绪不再受reference影响,情感张力更接近真人。
- 多语言声音克隆:跨语言音色克隆的错误率(CER / WER)取得了新层次的SOTA。
- 自然语言标签控制:沿用
[whisper]、[angry]、[laughing]等行内标签控制情绪与韵律。
相比 S2-Pro 的能力变化
| 能力 | S2-Pro | Drama 3 |
|---|---|---|
| 多说话人 | 支持 | 支持,剧本式多角色场景 |
| 声音克隆 | 支持 | 支持,多语言错误率更低 |
| 行内自然语言指令 | 支持 | 支持 |
| 局部修改 / 语音填空 | 不支持 | 支持 |
| 多轮导演修正 | 不支持 | 支持 |
| 长内容 | 分块生成 | 长对话与长语音,支持流式 |
| 强情绪表现(笑声、哭腔、耳语) | 一般 | 更强 |
效果
在公开基准上相对 S2 有显著跃升:多语言声音克隆(MiniMax Multilingual Testset)、自由形式语音编辑(Ming-Freeform)、多轮情绪修正(Step-Audio-Edit)三项上,控制精度、多语言错误率(CER / WER)与风格准确度全面超越前代。
完整架构、训练方案与评测结果见技术报告。
Fish Audio S2-Pro
我们的上一代旗舰模型,具有自然语言可控与富有情绪化的语音生成能力,支持近百种语言,且大小可供消费级GPU部署。
- 行内自然语言指令:用
[pause]、[excited]、[whisper]等标签在文本任意位置控制韵律与情绪。 - 原生多说话人生成:一段文本里用说话人 ID 区分角色,无需为每个角色单独生成后拼接。
- 快速语音克隆:10–30 秒参考音频即可复刻音色。
- 单次生成:可以一次性流式地生成长音频。
- 生产级流式:单张 H200 上 RTF 0.195、首音频延迟约 100 ms。
体验在线演示请访问 Fish Audio 网站,更多细节见博客文章与技术报告。
S2-Pro 基准测试结果(点击展开)
| 基准 | Fish Audio S2 | |------|------| | Seed-TTS Eval — WER(中文) | **0.54%**(总体最佳) | | Seed-TTS Eval — WER(英文) | **0.99%**(总体最佳) | | Audio Turing Test(含指令) | **0.515** 后验均值 | | EmergentTTS-Eval — 胜率 | **81.88%**(总体最高) | | Fish Instruction Benchmark — TAR | **93.3%** | | Fish Instruction Benchmark — 质量 | **4.51 / 5.0** | | 多语言(MiniMax Testset)— 最佳 WER | **24** 种语言中的 **11** 种 | | 多语言(MiniMax Testset)— 最佳 SIM | **24** 种语言中的 **17** 种 | 在 Seed-TTS Eval 上,S2 在所有已评估模型(包括闭源系统)中实现了最低 WER:Qwen3-TTS(0.77/1.24)、MiniMax Speech-02(0.99/1.90)、Seed-TTS(1.12/2.25)。在 Audio Turing Test 上,0.515 相比 Seed-TTS(0.417)提升 24%,相比 MiniMax-Speech(0.387)提升 33%。在 EmergentTTS-Eval 中,S2 在副语言学(91.61% 胜率)、疑问句(84.41%)和句法复杂度(83.39%)等维度表现尤为突出。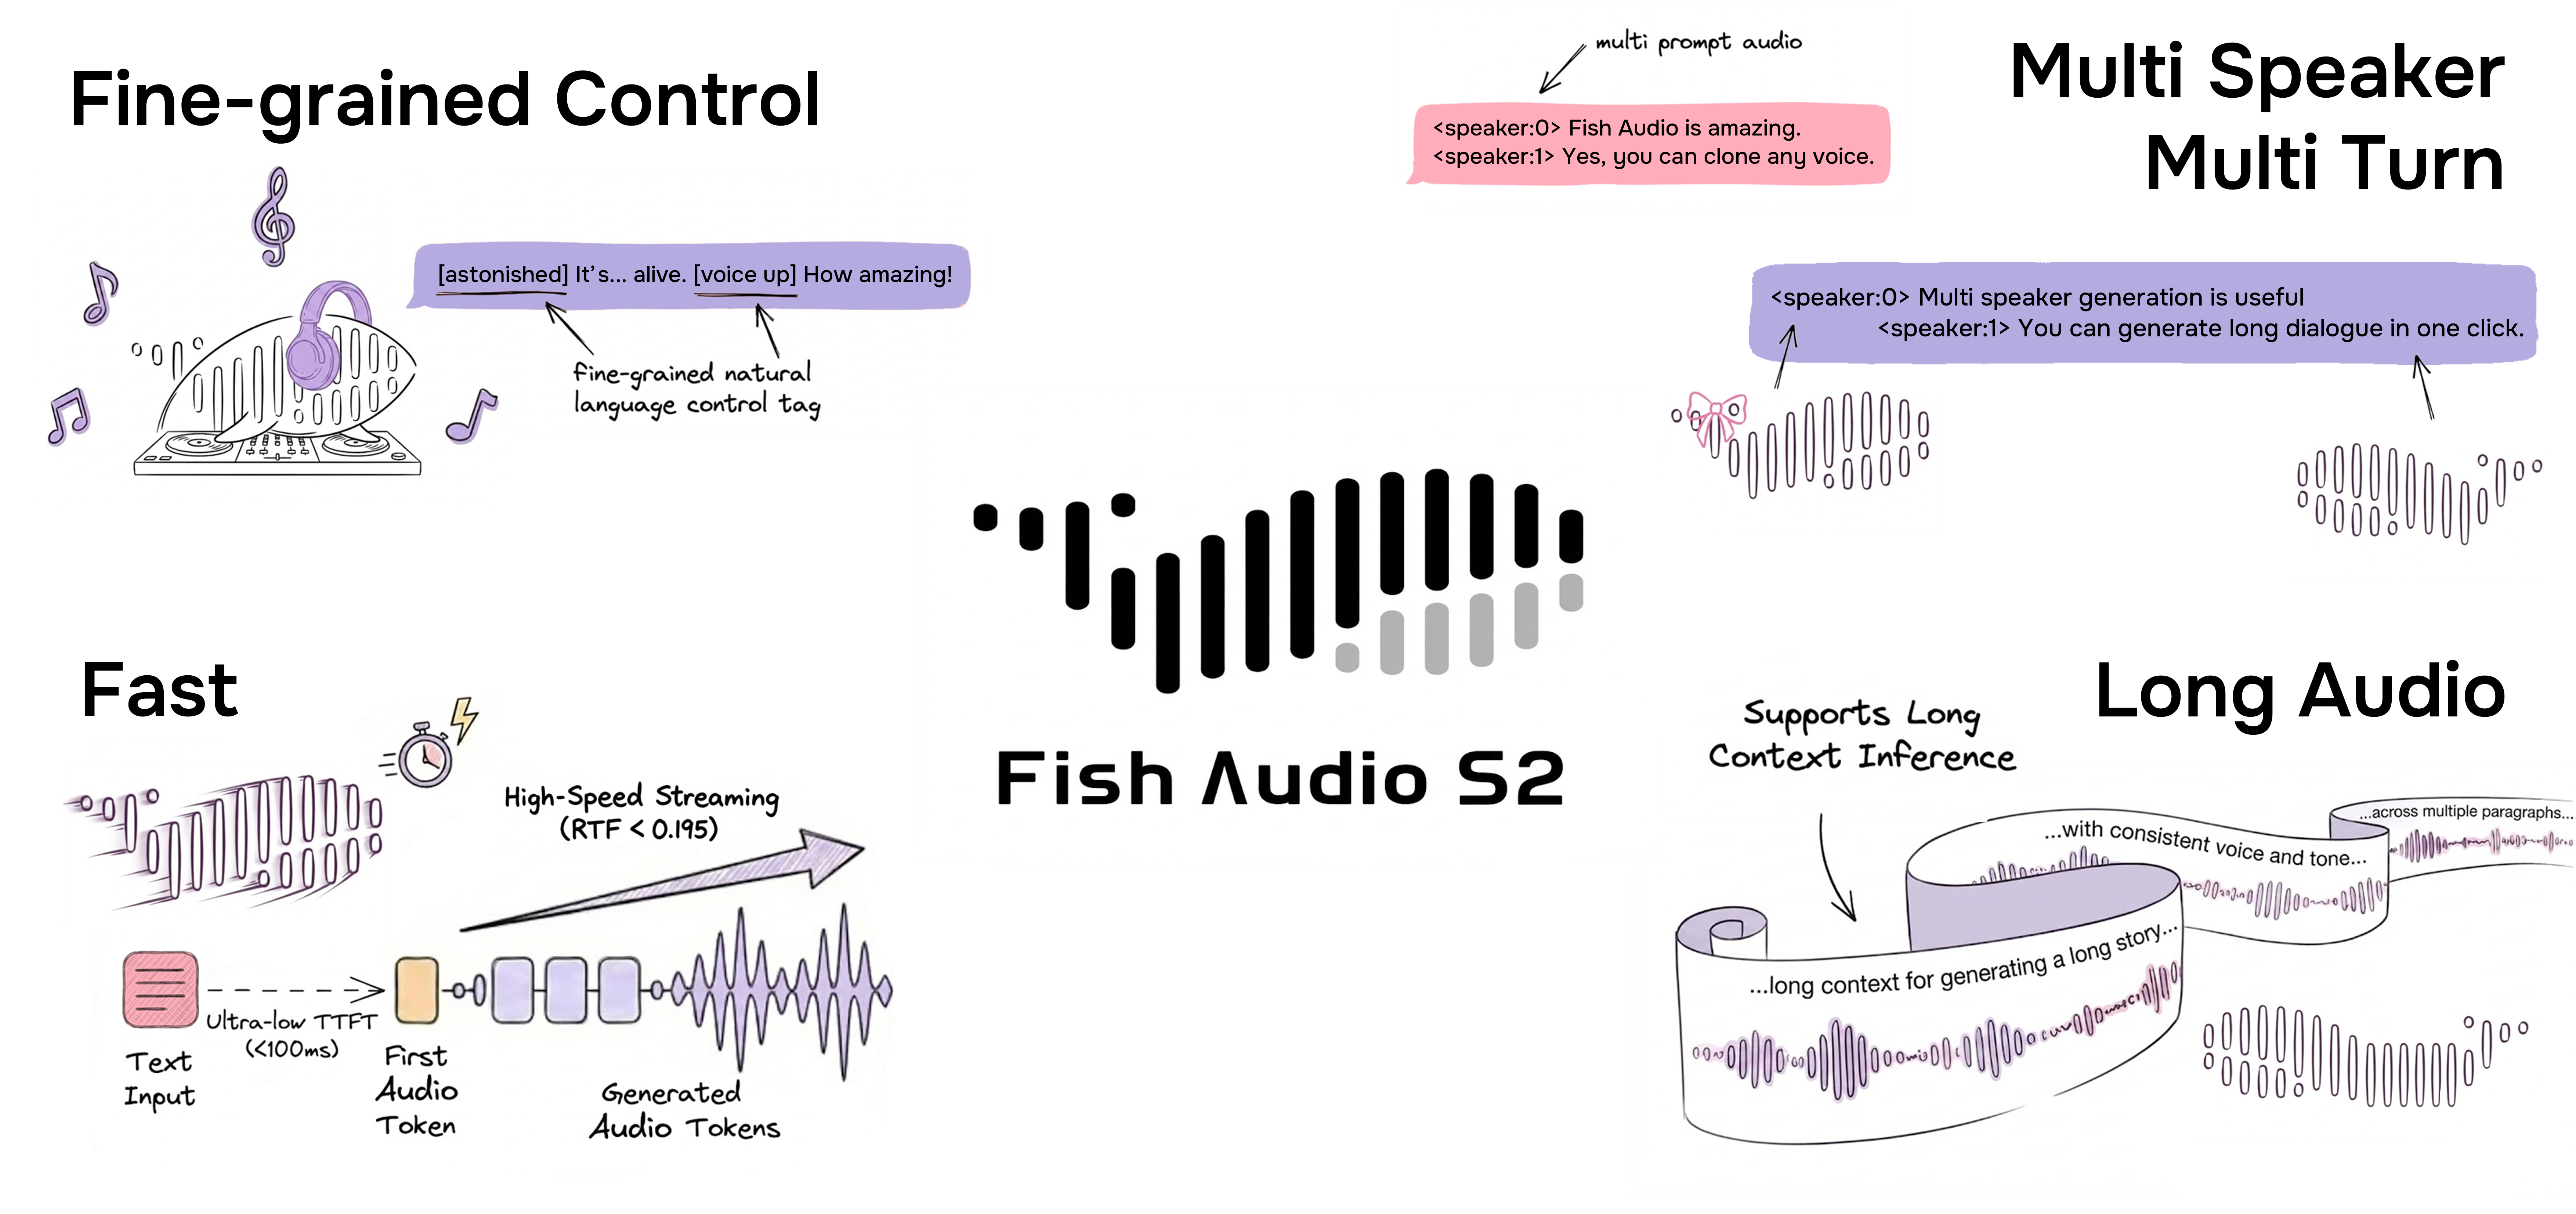
致谢
技术报告
@misc{fish-speech-v1.4,
      title={Fish-Speech: Leveraging Large Language Models for Advanced Multilingual Text-to-Speech Synthesis},
      author={Shijia Liao and Yuxuan Wang and Tianyu Li and Yifan Cheng and Ruoyi Zhang and Rongzhi Zhou and Yijin Xing},
      year={2024},
      eprint={2411.01156},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2411.01156},
}

@misc{liao2026fishaudios2technical,
      title={Fish Audio S2 Technical Report},
      author={Shijia Liao and Yuxuan Wang and Songting Liu and Yifan Cheng and Ruoyi Zhang and Tianyu Li and Shidong Li and Yisheng Zheng and Xingwei Liu and Qingzheng Wang and Zhizhuo Zhou and Jiahua Liu and Xin Chen and Dawei Han},
      year={2026},
      eprint={2603.08823},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2603.08823},
}

@misc{fishaudio2026drama3,
      title={Fish Audio Drama 3 Technical Report},
      author={Fish Audio Team},
      year={2026},
      howpublished={Technical report},
      url={https://github.com/fishaudio/fish-speech/blob/main/docs/assets/Fish_Audio_Drama_3_Technical_Report.pdf},
}