


라이선스 공지
이 코드베이스 및 관련 모델 가중치는 FISH AUDIO COMMUNITY LICENSE 하에 릴리스되었습니다. S2-Pro 가중치는 계속해서 Fish Audio Research License가 적용됩니다. 자세한 내용은 LICENSE를 참조하십시오.
법적 면책 조항
코드베이스의 불법적인 사용에 대해 당사는 어떠한 책임도 지지 않습니다. DMCA 및 기타 관련 법률에 관한 현지 규정을 참조하십시오.
빠른 시작
문서
[!IMPORTANT] 효율을 중시하는 사용자는 SGLang-Omni 사용을 강력히 권장합니다. SGLang-Omni README를 참고하세요.
LLM 에이전트용
모델
| 모델 | 크기 | 가중치 | 설명 |
|---|---|---|---|
| Drama 3 | 35B-A3B(토큰당 3B 활성화) | HuggingFace | 멀티 캐릭터 장면과 긴 콘텐츠를 위한 차세대 플래그십, 멀티턴 수정과 부분 편집 지원 |
| S2-Pro | 4B 파라미터 | HuggingFace | 이전 세대 플래그십, 더 빠른 추론 |
모델 종류는 가중치 디렉터리의 config.json에서 자동으로 판별되며, 두 모델은 동일한 명령줄과 API 서버를 공유합니다.
Fish Audio Drama 3
S2-Pro를 전면적으로 업그레이드한 차세대 음성 생성 모델.
Drama 3는 S2 시리즈와 마찬가지로 멀티 화자, 음성 클로닝, 자연어 제어를 지원하면서도 긴 오디오 처리, 상호작용 방식, 편집 가능성에서 뚜렷한 진전을 이뤘습니다.
주요 특징
- 멀티턴 디렉터 수정: 직전 테이크에 바로 지시를 내리고("더 부드럽게, 조금 더 슬프게"), 모델이 그 맥락을 반영해 다시 생성합니다. 처음부터 다시 할 필요가 없습니다.
- 인필링 & 정밀 편집: 텍스트를 고치듯 음성을 고쳐 "수요일"을 "목요일"로 바꾸는 식의 부분 교체가 가능하며, 앞뒤 음색과 연결은 자연스럽게 유지됩니다.
- 장면형 멀티 캐릭터 생성: 대본 설명만으로 여러 캐릭터가 등장하는 장면을 한 번에 녹음할 수 있고, 긴 텍스트 스트리밍 합성도 지원합니다.
- 긴 대화와 긴 음성: 긴 녹음과 긴 세션을 위해 설계되어, 긴 콘텐츠에서도 캐릭터와 음색이 안정적으로 유지됩니다.
- 표현력 강화: 웃음, 울먹임, 속삭임, 극적인 감정이 레퍼런스에 눌리지 않아 사람에 가까운 표현력을 냅니다.
- 다국어 음성 클로닝: 언어를 넘나드는 음색 클로닝의 오류율(CER / WER)에서 새로운 수준의 SOTA를 달성했습니다.
- 자연어 태그 제어:
[whisper],[angry],[laughing]등의 인라인 태그로 감정과 운율을 제어합니다.
S2-Pro 대비 달라진 점
| 기능 | S2-Pro | Drama 3 |
|---|---|---|
| 멀티 화자 | 지원 | 지원, 장면형 멀티 캐릭터 생성 |
| 음성 클로닝 | 지원 | 지원, 다국어 오류율이 더 낮음 |
| 인라인 자연어 지시 | 지원 | 지원 |
| 부분 편집 / 인필링 | 미지원 | 지원 |
| 멀티턴 디렉터 수정 | 미지원 | 지원 |
| 긴 콘텐츠 | 청크 분할 생성 | 긴 대화와 긴 음성, 스트리밍 지원 |
| 강한 감정 표현(웃음, 울먹임, 속삭임) | 보통 | 더 강함 |
성능
공개 벤치마크에서 S2 대비 뚜렷한 도약을 이뤘습니다: 다국어 음성 클로닝(MiniMax Multilingual Testset), 자유 형식 음성 편집(Ming-Freeform), 멀티턴 감정 수정(Step-Audio-Edit) 세 영역에서 제어 정밀도, 다국어 오류율(CER / WER), 스타일 정확도 모두 이전 세대를 넘어섭니다.
아키텍처, 학습 방법, 전체 평가 결과는 기술 보고서를 참고하세요.
Fish Audio S2-Pro
자연어 제어와 감정 표현에 강점이 있는 이전 세대 플래그십 모델입니다. 약 100개 언어를 지원하고, 소비자용 GPU에도 올릴 수 있는 크기입니다.
- 인라인 자연어 지시:
[pause],[excited],[whisper]등의 태그로 텍스트 원하는 위치의 운율과 감정을 제어합니다. - 네이티브 멀티 화자 생성: 하나의 텍스트 안에서 화자 ID로 캐릭터를 구분하므로, 화자별로 따로 생성해 이어 붙일 필요가 없습니다.
- 빠른 음성 클로닝: 10~30초의 참조 오디오로 음색을 재현합니다.
- 단일 패스: 긴 오디오를 한 번에 스트리밍으로 생성할 수 있습니다.
- 프로덕션 스트리밍: H200 단일 카드에서 RTF 0.195, 첫 오디오까지 약 100 ms.
온라인 데모는 Fish Audio 웹사이트에서 체험할 수 있고, 자세한 내용은 블로그 글과 기술 보고서를 참고하세요.
S2-Pro 벤치마크 결과(펼치기)
| 벤치마크 | Fish Audio S2 | |------|------| | Seed-TTS Eval — WER(중국어) | **0.54%**(전체 최고) | | Seed-TTS Eval — WER(영어) | **0.99%**(전체 최고) | | Audio Turing Test(지시 포함) | **0.515** 사후 평균 | | EmergentTTS-Eval — 승률 | **81.88%**(전체 최고) | | Fish Instruction Benchmark — TAR | **93.3%** | | Fish Instruction Benchmark — 품질 | **4.51 / 5.0** | | 다국어(MiniMax Testset) — 최고 WER | **24**개 언어 중 **11**개 | | 다국어(MiniMax Testset) — 최고 SIM | **24**개 언어 중 **17**개 | Seed-TTS Eval에서 S2는 폐쇄형 시스템을 포함한 모든 평가 모델 중 가장 낮은 WER을 기록했습니다: Qwen3-TTS(0.77/1.24), MiniMax Speech-02(0.99/1.90), Seed-TTS(1.12/2.25). Audio Turing Test에서 0.515는 Seed-TTS(0.417)보다 24%, MiniMax-Speech(0.387)보다 33% 높습니다. EmergentTTS-Eval에서는 준언어학(승률 91.61%), 의문문(84.41%), 통사적 복잡성(83.39%)에서 특히 강한 결과를 보입니다.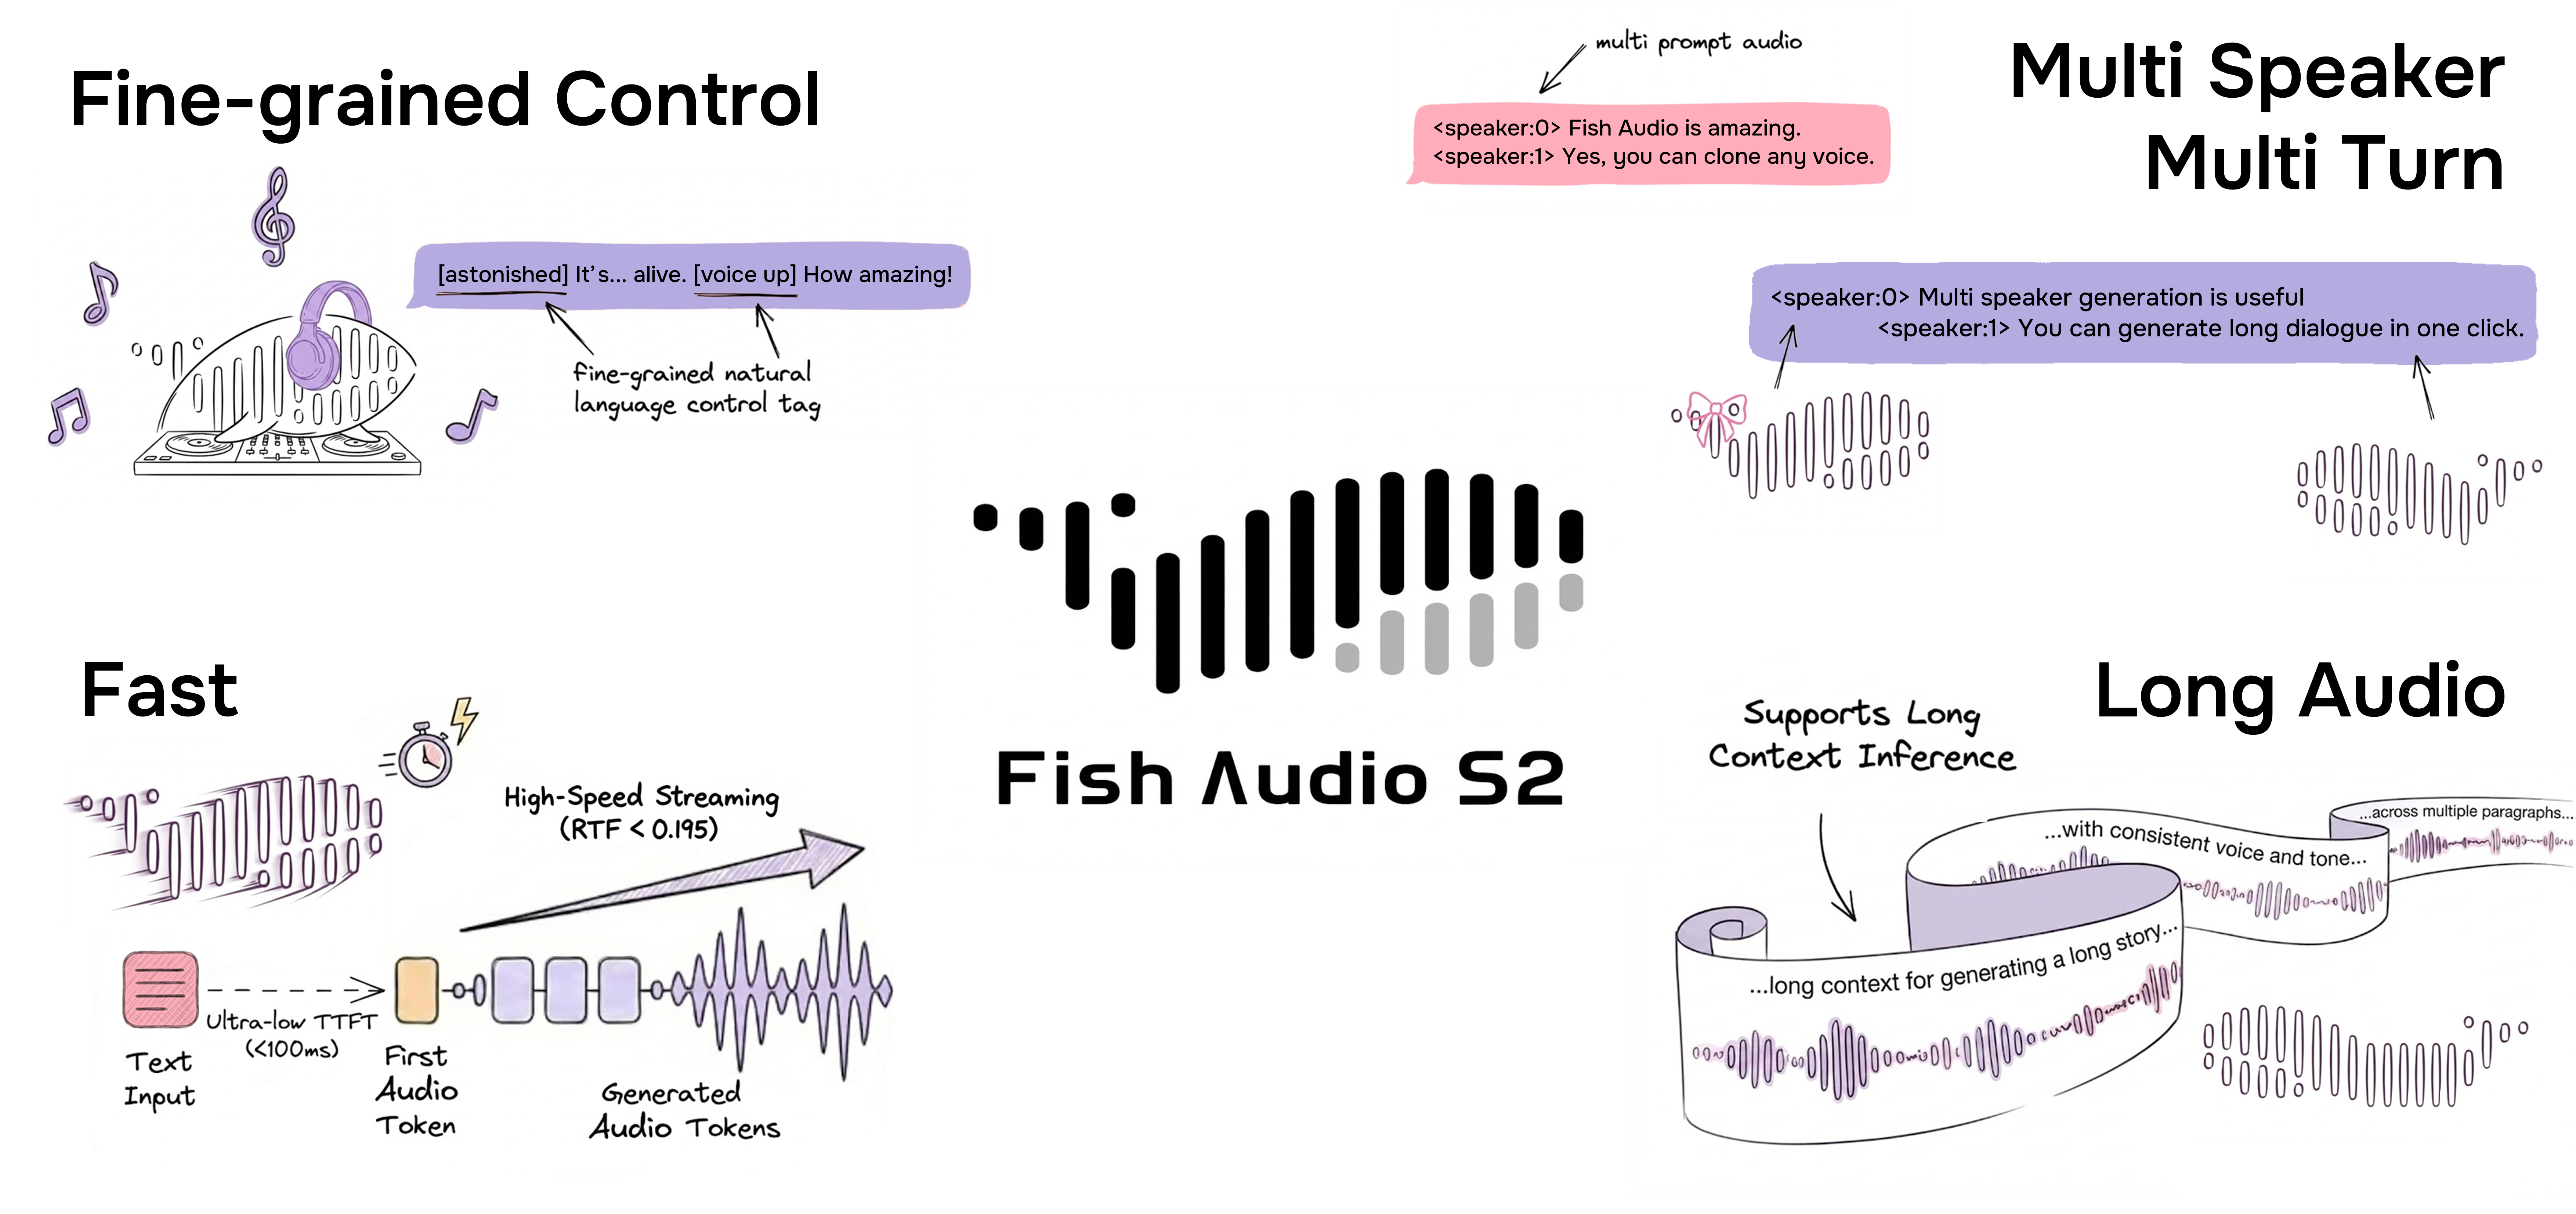
크레딧
기술 보고서
@misc{fish-speech-v1.4,
      title={Fish-Speech: Leveraging Large Language Models for Advanced Multilingual Text-to-Speech Synthesis},
      author={Shijia Liao and Yuxuan Wang and Tianyu Li and Yifan Cheng and Ruoyi Zhang and Rongzhi Zhou and Yijin Xing},
      year={2024},
      eprint={2411.01156},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2411.01156},
}

@misc{liao2026fishaudios2technical,
      title={Fish Audio S2 Technical Report},
      author={Shijia Liao and Yuxuan Wang and Songting Liu and Yifan Cheng and Ruoyi Zhang and Tianyu Li and Shidong Li and Yisheng Zheng and Xingwei Liu and Qingzheng Wang and Zhizhuo Zhou and Jiahua Liu and Xin Chen and Dawei Han},
      year={2026},
      eprint={2603.08823},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2603.08823},
}

@misc{liao2026fishaudiodrama3technical,
      title={Fish Audio Drama 3 Technical Report},
      author={Dawei Han and Shidong Li and Shijia Liao and Jiahua Liu and Songting Liu and Qingzheng Wang and Yuxuan Wang and Xin Chen and Yifan Cheng and Tianyu Li and Gangin Park and Xuehao Yang and Chang Zeng and Haoyang Zhang and Ruoyi Zhang and Xiangyu Zhang},
      year={2026},
      eprint={2610.18010},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2610.18010},
}