


تنبيه الترخيص
يتم إصدار قاعدة الأكواد هذه وأوزان النماذج المرتبطة بها بموجب رخصة FISH AUDIO COMMUNITY LICENSE. تظل أوزان S2-Pro خاضعة لترخيص Fish Audio Research License. يرجى الرجوع إلى LICENSE لمزيد من التفاصيل.
إخلاء المسؤولية القانونية
نحن لا نتحمل أي مسؤولية عن أي استخدام غير قانوني لقاعدة الأكواد. يرجى مراجعة القوانين المحلية المتعلقة بـ DMCA والقوانين الأخرى ذات الصلة.
البدء السريع
الوثائق
- التثبيت: إعداد البيئة، تحميل الأوزان، النشر باستخدام Docker
- الاستنتاج: سطر الأوامر، خادم API، واجهة WebUI
[!IMPORTANT] نوصي بشدة من يبحث عن الكفاءة باستخدام SGLang-Omni؛ راجع SGLang-Omni README.
لوكيل LLM
اقرأ https://speech.fish.audio/ar/install/ أولاً، واتبع الوثائق لتثبيت وإعداد Fish Audio Drama 3 (أو S2-Pro).
النماذج
| النموذج | الحجم | الأوزان | الوصف |
|---|---|---|---|
| Drama 3 | 35B-A3B (يُنشَّط منها 3B لكل رمز) | HuggingFace | النموذج الرائد من الجيل الجديد، مخصص للمشاهد متعددة الشخصيات والمحتوى الطويل، مع المراجعة متعددة الأدوار والتحرير الموضعي |
| S2-Pro | 4B معامل | HuggingFace | النموذج الرائد من الجيل السابق، باستنتاج أسرع |
يُستنتج نوع النموذج من ملف config.json في مجلد الأوزان، ويتشارك النموذجان في نفس سطر الأوامر وخادم API.
Fish Audio Drama 3
نموذج صوتي من الجيل الجديد، يرتقي عن S2-Pro من جميع الجوانب.
يدعم Drama 3، كما في سلسلة S2، تعدد المتحدثين واستنساخ الصوت والتحكم باللغة الطبيعية، لكنه يحقق قفزة واضحة في التعامل مع الصوت الطويل وفي طريقة التفاعل وقابلية التحرير.
المميزات الرئيسية
- المراجعة متعددة الأدوار (إخراج): وجّه اللقطة السابقة مباشرة ("أكثر هدوءً، وأكثر حزنًا قليلًا")، فيعيد النموذج التوليد مع أخذ هذا السياق في الاعتبار دون البدء من الصفر.
- الإقحام (Infilling) والتحرير الدقيق: حرّر الصوت كما تحرّر النص، فتبدّل كلمة واحدة (من "الأربعاء" إلى "الخميس") مع بقاء لون الصوت والانتقالات قبلها وبعدها طبيعية.
- مشاهد متعددة الشخصيات: من وصف النص المسرحي، يمكنك تسجيل مشهد كامل يضم عدة شخصيات دفعة واحدة، مع دعم التدفق للنصوص الطويلة.
- حوارات طويلة وصوت طويل: صُمم للتسجيلات الطويلة والجلسات الممتدة، مع الحفاظ على ثبات الشخصيات ولون الصوت في المحتوى الطويل.
- تعبير أقوى: الضحك والبكاء والهمس والمشاعر الدرامية لم تعد تُسطّح بسبب المرجع، فصار الأداء أقرب إلى أداء بشري حقيقي.
- استنساخ صوتي متعدد اللغات: يحقق مستوى جديدًا من SOTA في معدلات الخطأ (CER / WER) لاستنساخ لون الصوت عبر اللغات.
- التحكم بوسوم اللغة الطبيعية: وسوم داخلية مثل
[whisper]و[angry]و[laughing]تتحكم في المشاعر والنغم.
ما تغيّر مقارنةً بـ S2-Pro
| القدرة | S2-Pro | Drama 3 |
|---|---|---|
| تعدد المتحدثين | مدعوم | مدعوم، كمشاهد متعددة الشخصيات |
| استنساخ الصوت | مدعوم | مدعوم، بمعدلات خطأ أقل عبر اللغات |
| تعليمات اللغة الطبيعية الداخلية | مدعومة | مدعومة |
| التحرير الموضعي / الإقحام | غير مدعوم | مدعوم |
| المراجعة متعددة الأدوار | غير مدعومة | مدعومة |
| المحتوى الطويل | توليد على مقاطع | حوارات طويلة وصوت طويل، مع التدفق |
| المشاعر القوية (الضحك، البكاء، الهمس) | متوسطة | أقوى |
النتائج
يحقق Drama 3 قفزة واضحة على S2 في المعايير العامة: الاستنساخ الصوتي متعدد اللغات (MiniMax Multilingual Testset)، وتحرير الكلام بالشكل الحر (Ming-Freeform)، والمراجعة العاطفية متعددة الأدوار (Step-Audio-Edit)، حيث يتجاوز الجيل السابق في دقة التحكم ومعدلات الخطأ متعددة اللغات (CER / WER) ودقة الأسلوب.
راجع التقرير التقني للاطّلاع على البنية المعمارية وطريقة التدريب ونتائج التقييم الكاملة.
Fish Audio S2-Pro
نموذجنا الرائد من الجيل السابق: كلام قابل للتحكم باللغة الطبيعية وغني بالمشاعر، يدعم نحو مئة لغة، وبحجم يمكن نشره على بطاقة GPU للمستهلكين.
- تعليمات اللغة الطبيعية الداخلية: وسوم مثل
[pause]و[excited]و[whisper]تتحكم في النغم والمشاعر في أي موضع من النص. - توليد أصلي متعدد المتحدثين: تفصل معرّفات المتحدثين بين الشخصيات داخل نص واحد، فلا حاجة إلى توليد كل متحدث ثم وصل المقاطع.
- استنساخ صوتي سريع: يكفي 10–30 ثانية من الصوت المرجعي لإعادة إنتاج لون الصوت.
- توليد بدفعة واحدة: يمكن توليد صوت طويل متدفقًا دفعة واحدة.
- تدفق بمستوى الإنتاج: RTF 0.195 على بطاقة H200 واحدة، وزمن نحو 100 مللي ثانية حتى أول صوت.
جرّب العرض المباشر على موقع Fish Audio، واقرأ تدوينة المدونة والتقرير التقني لمزيد من التفاصيل.
نتائج قياس S2-Pro (انقر للتوسيع)
| المعيار | Fish Audio S2 | |------|------| | Seed-TTS Eval — WER (الصينية) | **0.54%** (الأفضل إجمالًا) | | Seed-TTS Eval — WER (الإنجليزية) | **0.99%** (الأفضل إجمالًا) | | Audio Turing Test (مع تعليمات) | **0.515** متوسط لاحق | | EmergentTTS-Eval — معدل الفوز | **81.88%** (الأعلى إجمالًا) | | Fish Instruction Benchmark — TAR | **93.3%** | | Fish Instruction Benchmark — الجودة | **4.51 / 5.0** | | متعدد اللغات (MiniMax Testset) — أفضل WER | **11 من 24** لغة | | متعدد اللغات (MiniMax Testset) — أفضل SIM | **17 من 24** لغة | في Seed-TTS Eval، حقق S2 أقل WER بين جميع النماذج المقيَّمة بما فيها الأنظمة مغلقة المصدر: Qwen3-TTS (0.77/1.24)، MiniMax Speech-02 (0.99/1.90)، Seed-TTS (1.12/2.25). وفي Audio Turing Test، يتفوق 0.515 على Seed-TTS (0.417) بنسبة 24% وعلى MiniMax-Speech (0.387) بنسبة 33%. وفي EmergentTTS-Eval، يبرز S2 خصوصًا في علم اللغة الموازي (معدل فوز 91.61%) والأسئلة (84.41%) والتعقيد النحوي (83.39%).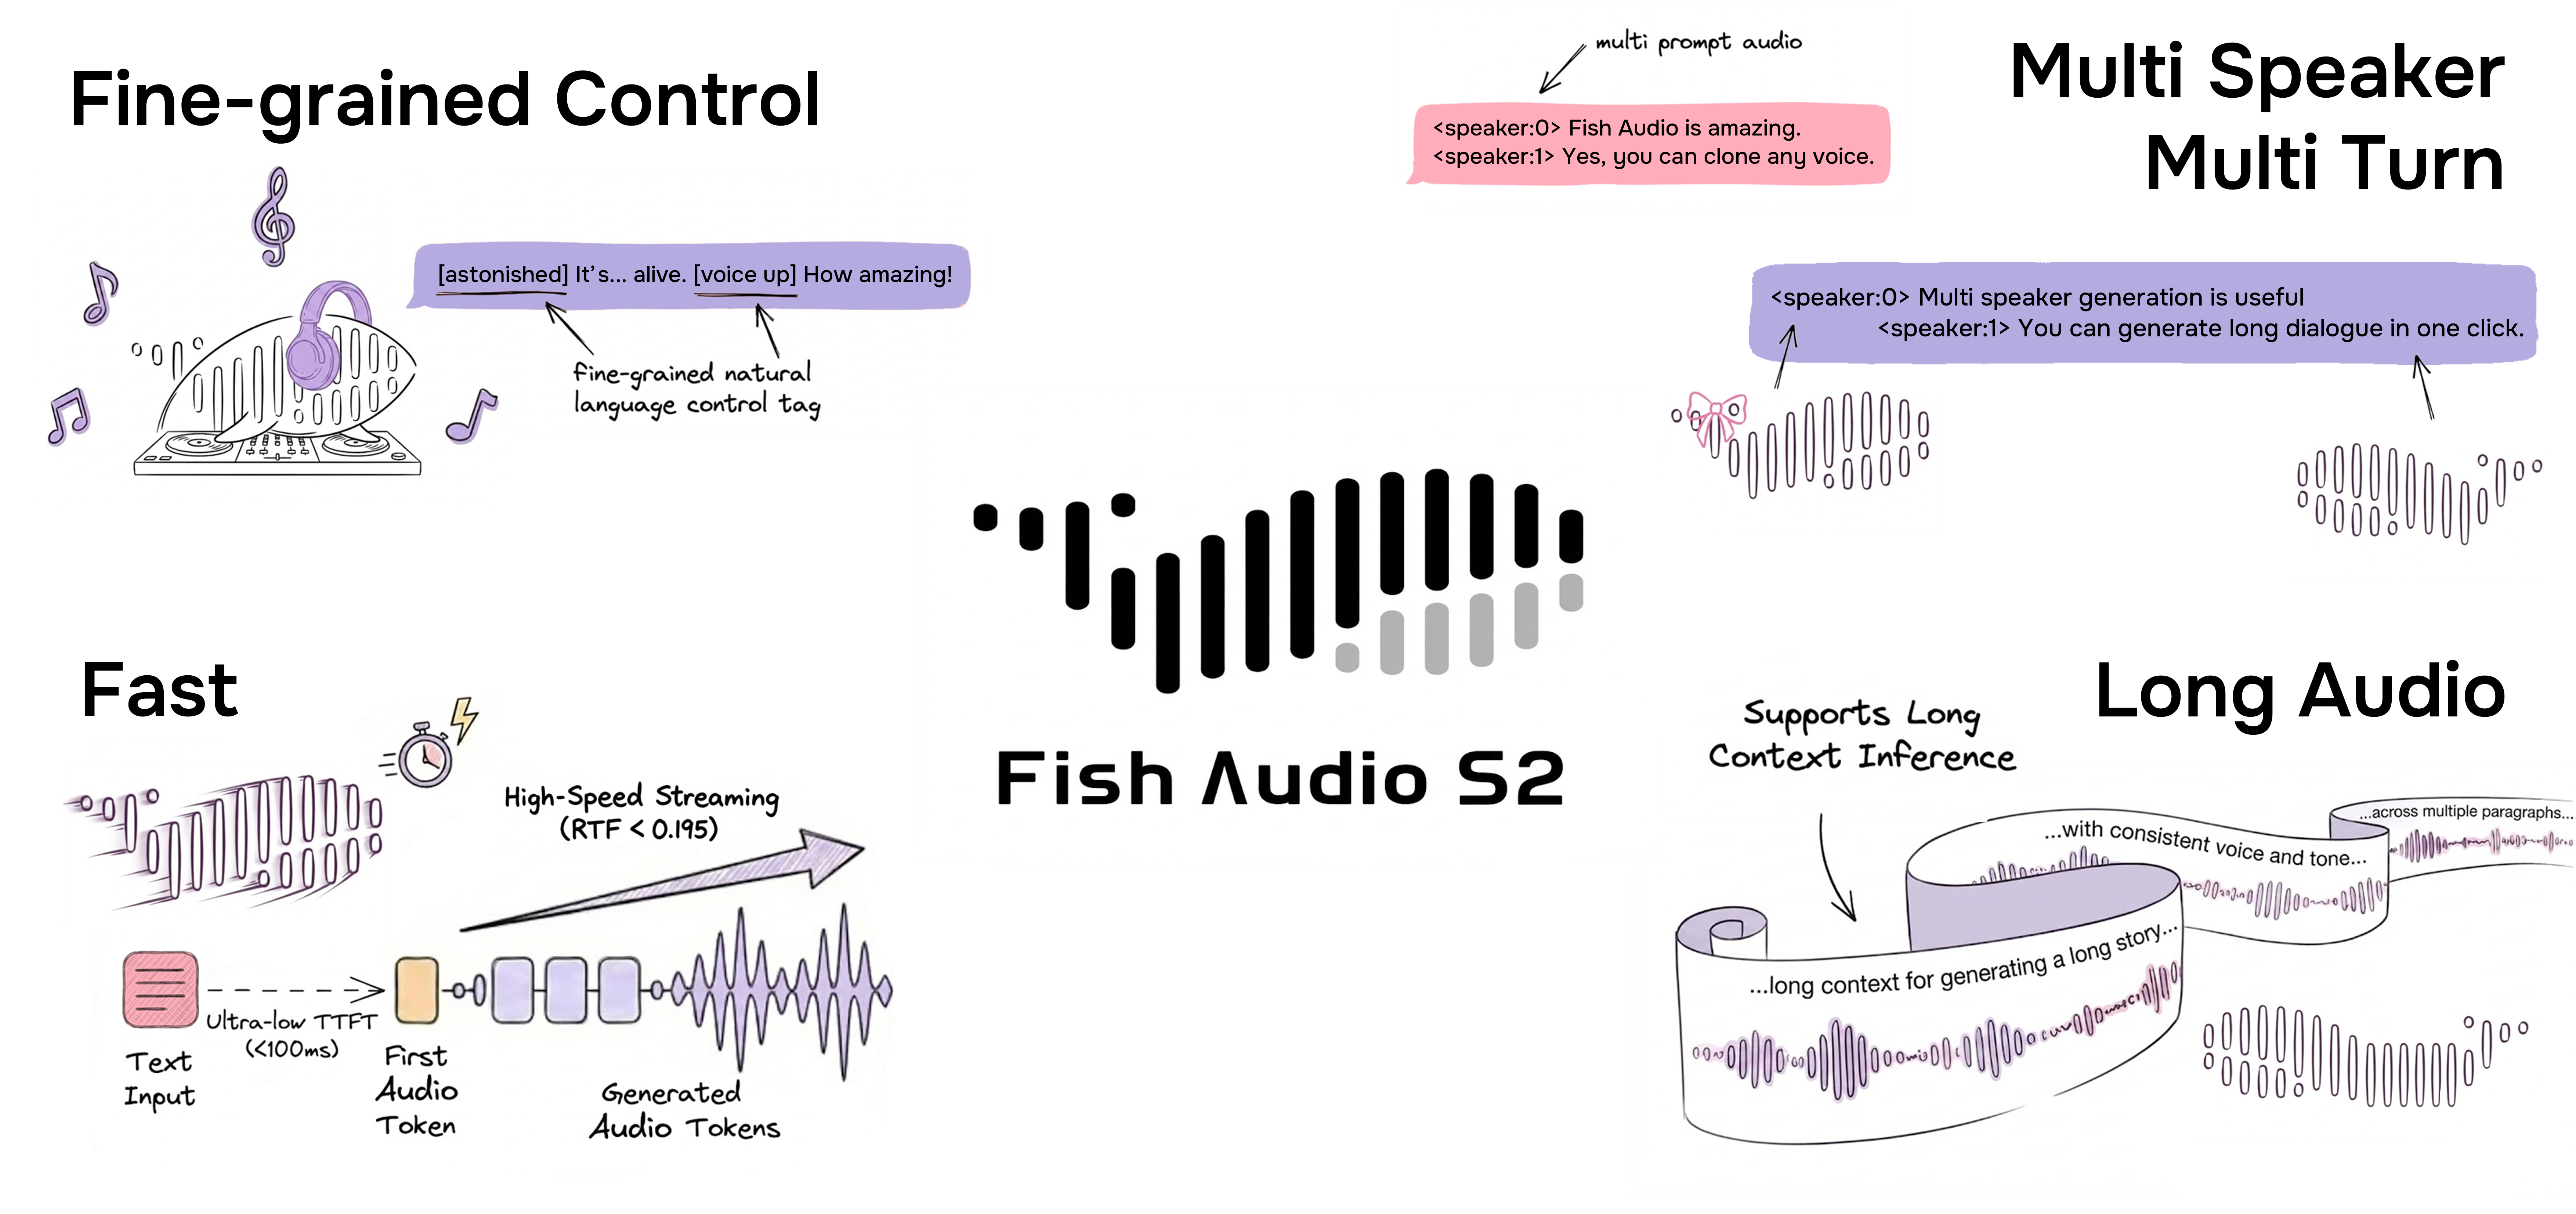
شكر وتقدير
التقرير التقني
@misc{fish-speech-v1.4,
      title={Fish-Speech: Leveraging Large Language Models for Advanced Multilingual Text-to-Speech Synthesis},
      author={Shijia Liao and Yuxuan Wang and Tianyu Li and Yifan Cheng and Ruoyi Zhang and Rongzhi Zhou and Yijin Xing},
      year={2024},
      eprint={2411.01156},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2411.01156},
}

@misc{liao2026fishaudios2technical,
      title={Fish Audio S2 Technical Report},
      author={Shijia Liao and Yuxuan Wang and Songting Liu and Yifan Cheng and Ruoyi Zhang and Tianyu Li and Shidong Li and Yisheng Zheng and Xingwei Liu and Qingzheng Wang and Zhizhuo Zhou and Jiahua Liu and Xin Chen and Dawei Han},
      year={2026},
      eprint={2603.08823},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2603.08823},
}

@misc{fishaudio2026drama3,
      title={Fish Audio Drama 3 Technical Report},
      author={Fish Audio Team},
      year={2026},
      howpublished={Technical report},
      url={https://github.com/fishaudio/fish-speech/blob/main/docs/assets/Fish_Audio_Drama_3_Technical_Report.pdf},
}