


Aviso de Licencia
Este código y sus pesos de modelo asociados se publican bajo FISH AUDIO COMMUNITY LICENSE. Los pesos de S2-Pro siguen bajo la Fish Audio Research License. Por favor, consulta LICENSE para más detalles. Tomaremos acciones contra cualquier violación de la licencia.
Aviso Legal
No asumimos ninguna responsabilidad por el uso ilegal de este código. Por favor, consulta las leyes locales sobre DMCA y otras leyes relacionadas.
Inicio Rápido
Documentación
- Instalación: configuración del entorno, descarga de pesos, despliegue con Docker
- Inferencia: línea de comandos, servidor API, WebUI
[!IMPORTANT] Recomendamos especialmente SGLang-Omni a quienes busquen eficiencia; consulta el SGLang-Omni README.
Para Agentes LLM
Lee primero https://speech.fish.audio/es/install/ y sigue la documentación para instalar y configurar Fish Audio Drama 3 (o S2-Pro).
Modelos
| Modelo | Tamaño | Pesos | Descripción |
|---|---|---|---|
| Drama 3 | 35B-A3B (3B activos por token) | HuggingFace | Nuevo modelo insignia para escenas con varios personajes y contenido largo, con revisión en varios turnos y edición local |
| S2-Pro | 4B parámetros | HuggingFace | Modelo insignia de la generación anterior, con inferencia más rápida |
El tipo de modelo se detecta a partir del config.json del directorio de pesos y ambos comparten la misma línea de comandos y el mismo servidor API.
Fish Audio Drama 3
El nuevo modelo de voz, con una mejora integral respecto a S2-Pro.
Al igual que la serie S2, Drama 3 admite varios hablantes, clonación de voz y control por lenguaje natural, pero da un salto claro en el manejo de audio largo, en la forma de interactuar y en la capacidad de edición.
Características principales
- Revisión en varios turnos (dirección): orienta la toma anterior directamente ("más suave, un poco más triste") y el modelo la regenera teniendo ese contexto en cuenta, sin empezar de cero.
- Relleno (infilling) y edición precisa: edita el audio como editas el texto, sustituyendo una sola palabra (de "miércoles" a "jueves") y manteniendo naturales el timbre y las transiciones.
- Escenas con varios personajes: a partir de la descripción del guion, graba una escena completa con varios personajes de una sola vez, con soporte de streaming para texto largo.
- Diálogos largos y audio largo: pensado para grabaciones extensas y sesiones prolongadas, manteniendo estables los personajes y el timbre en contenidos largos.
- Mayor expresividad: la risa, el llanto, los susurros y la emoción dramática dejan de verse aplanados por la referencia, y la interpretación se acerca mucho más a la de una persona real.
- Clonación de voz multilingüe: alcanza un nuevo nivel de SOTA en las tasas de error (CER / WER) de la clonación entre idiomas.
- Control mediante etiquetas de lenguaje natural: etiquetas en línea como
[whisper],[angry]y[laughing]controlan la emoción y la prosodia.
Qué cambia respecto a S2-Pro
| Capacidad | S2-Pro | Drama 3 |
|---|---|---|
| Varios hablantes | Compatible | Compatible, como escenas con varios personajes |
| Clonación de voz | Compatible | Compatible, con menores tasas de error multilingüe |
| Instrucciones en línea en lenguaje natural | Compatible | Compatible |
| Edición local / relleno | No compatible | Compatible |
| Revisión en varios turnos | No compatible | Compatible |
| Contenido largo | Generación por bloques | Diálogos largos y audio largo, con streaming |
| Emoción intensa (risa, llanto, susurros) | Moderada | Mayor |
Resultados
Drama 3 da un salto claro respecto a S2 en bancos de pruebas públicos: clonación de voz multilingüe (MiniMax Multilingual Testset), edición de voz de forma libre (Ming-Freeform) y revisión emocional en varios turnos (Step-Audio-Edit), donde supera a la generación anterior en precisión de control, tasas de error multilingües (CER / WER) y precisión de estilo.
Consulta el informe técnico para la arquitectura, la receta de entrenamiento y los resultados completos de la evaluación.
Fish Audio S2-Pro
Nuestro modelo insignia de la generación anterior: voz controlable por lenguaje natural y con gran carga emocional, compatible con cerca de un centenar de idiomas y con un tamaño que cabe en una GPU de consumo.
- Instrucciones en línea en lenguaje natural: etiquetas como
[pause],[excited]y[whisper]controlan la prosodia y la emoción en cualquier punto del texto. - Generación nativa con varios hablantes: los ID de hablante separan los personajes dentro de un mismo texto, sin tener que generar y concatenar un hablante cada vez.
- Clonación rápida de voz: bastan 10–30 segundos de audio de referencia para reproducir un timbre.
- Pasada única: el audio largo puede generarse en streaming de una sola vez.
- Streaming de producción: RTF 0.195 en una sola H200 y unos 100 ms hasta el primer audio.
Prueba la demostración en línea en el sitio web de Fish Audio y lee la entrada del blog y el informe técnico para más detalles.
Resultados de benchmark de S2-Pro (haz clic para expandir)
| Benchmark | Fish Audio S2 | |------|------| | Seed-TTS Eval — WER (chino) | **0,54%** (mejor en general) | | Seed-TTS Eval — WER (inglés) | **0,99%** (mejor en general) | | Audio Turing Test (con instrucción) | **0,515** media posterior | | EmergentTTS-Eval — Tasa de victoria | **81,88%** (la más alta en general) | | Fish Instruction Benchmark — TAR | **93,3%** | | Fish Instruction Benchmark — Calidad | **4,51 / 5,0** | | Multilingüe (MiniMax Testset) — Mejor WER | **11 de 24** idiomas | | Multilingüe (MiniMax Testset) — Mejor SIM | **17 de 24** idiomas | En Seed-TTS Eval, S2 logra el WER más bajo de todos los modelos evaluados, incluidos los sistemas cerrados: Qwen3-TTS (0,77/1,24), MiniMax Speech-02 (0,99/1,90), Seed-TTS (1,12/2,25). En el Audio Turing Test, 0,515 supera a Seed-TTS (0,417) en un 24% y a MiniMax-Speech (0,387) en un 33%. En EmergentTTS-Eval, S2 destaca especialmente en paralingüística (tasa de victoria del 91,61%), preguntas (84,41%) y complejidad sintáctica (83,39%).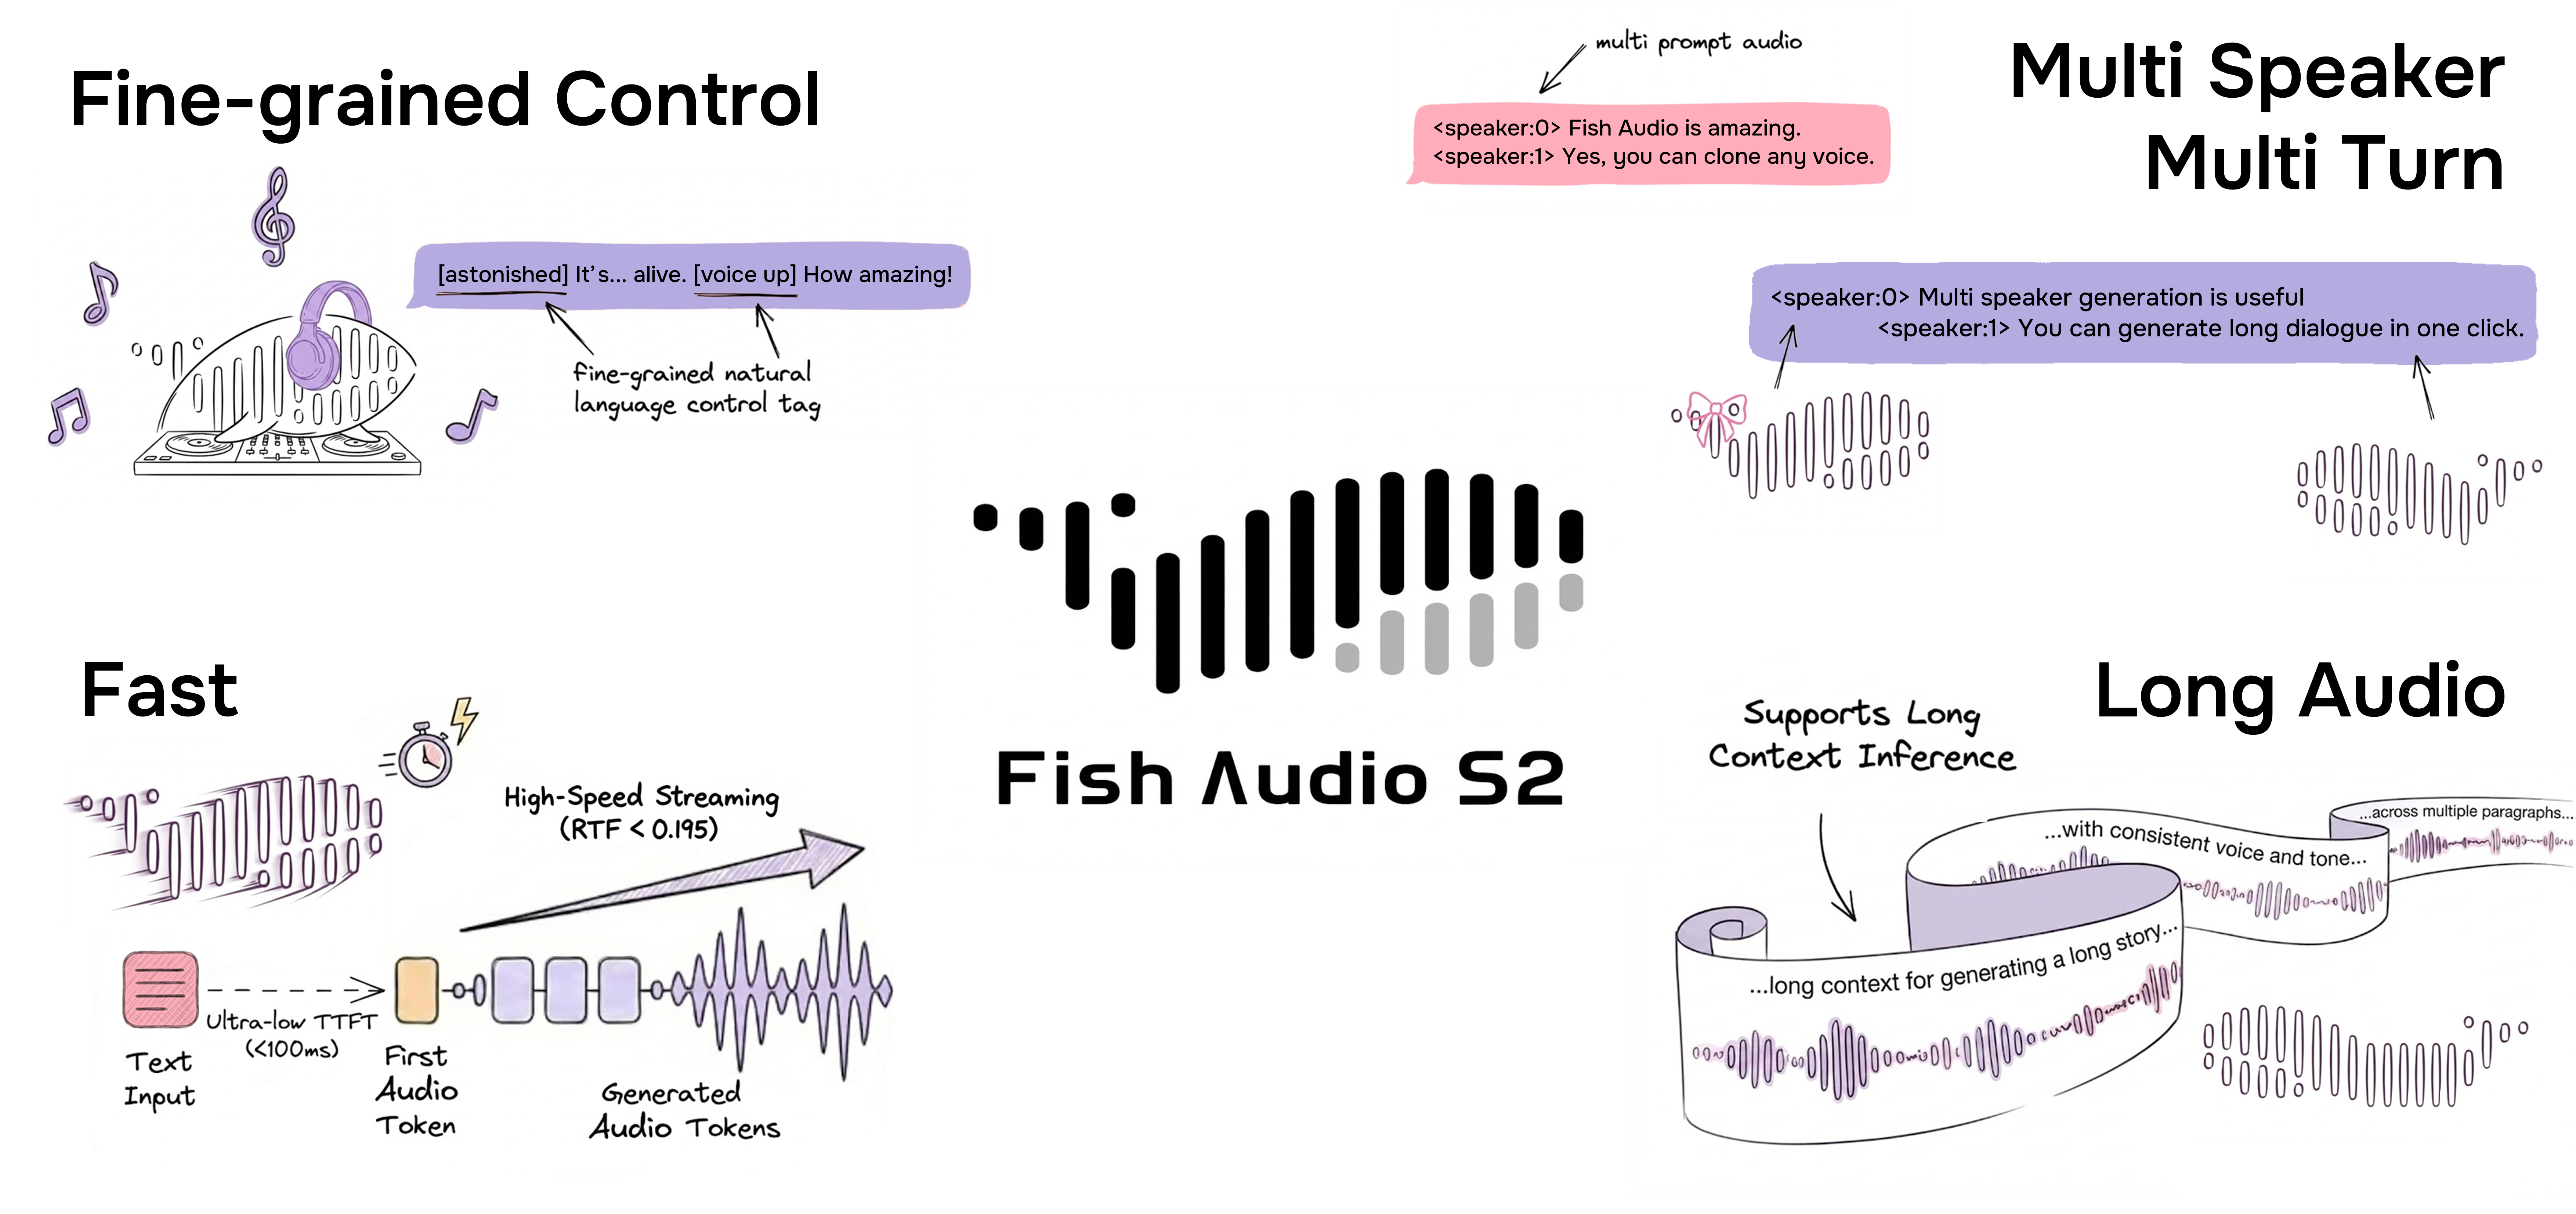
Créditos
Reporte Técnico
@misc{fish-speech-v1.4,
      title={Fish-Speech: Leveraging Large Language Models for Advanced Multilingual Text-to-Speech Synthesis},
      author={Shijia Liao and Yuxuan Wang and Tianyu Li and Yifan Cheng and Ruoyi Zhang and Rongzhi Zhou and Yijin Xing},
      year={2024},
      eprint={2411.01156},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2411.01156},
}

@misc{liao2026fishaudios2technical,
      title={Fish Audio S2 Technical Report},
      author={Shijia Liao and Yuxuan Wang and Songting Liu and Yifan Cheng and Ruoyi Zhang and Tianyu Li and Shidong Li and Yisheng Zheng and Xingwei Liu and Qingzheng Wang and Zhizhuo Zhou and Jiahua Liu and Xin Chen and Dawei Han},
      year={2026},
      eprint={2603.08823},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2603.08823},
}

@misc{liao2026fishaudiodrama3technical,
      title={Fish Audio Drama 3 Technical Report},
      author={Dawei Han and Shidong Li and Shijia Liao and Jiahua Liu and Songting Liu and Qingzheng Wang and Yuxuan Wang and Xin Chen and Yifan Cheng and Tianyu Li and Gangin Park and Xuehao Yang and Chang Zeng and Haoyang Zhang and Ruoyi Zhang and Xiangyu Zhang},
      year={2026},
      eprint={2610.18010},
      archivePrefix={arXiv},
      primaryClass={cs.SD},
      url={https://arxiv.org/abs/2610.18010},
}